RAG und Embeddings: Firmenwissen für KI nutzbar machen
Moderne KI-Sprachmodelle wie GPT oder Claude sind beeindruckend vielseitig – aber sie kennen weder Ihre internen Prozessdokumente noch Ihre Produkthandbücher oder vergangenen Projektberichte. Genau hier setzt Retrieval-Augmented Generation, kurz RAG, an: eine Architektur, die es ermöglicht, unternehmenseigenes Wissen gezielt in KI-Antworten einfließen zu lassen, ohne das Modell selbst neu zu trainieren.
Was RAG von klassischen KI-Ansätzen unterscheidet
Beim klassischen Einsatz eines Sprachmodells ist das Wissen im Modell eingefroren – es entspricht dem Stand des letzten Trainings. Fine-Tuning, also das Nachtrainieren auf eigenen Daten, ist aufwändig, teuer und muss bei jeder Wissensänderung wiederholt werden. RAG geht einen anderen Weg: Das Modell wird zur Laufzeit mit relevantem Kontext aus einer eigenen Wissensbasis versorgt. Es antwortet also nicht aus dem Gedächtnis, sondern auf Basis von Dokumenten, die dynamisch abgerufen werden.
Das Ergebnis: Die KI kann präzise auf unternehmensspezifische Fragen antworten – etwa zu internen Richtlinien, Produktspezifikationen oder historischen Projektdaten – und bleibt dabei stets aktuell, solange die Wissensbasis gepflegt wird.
Die Rolle von Embeddings
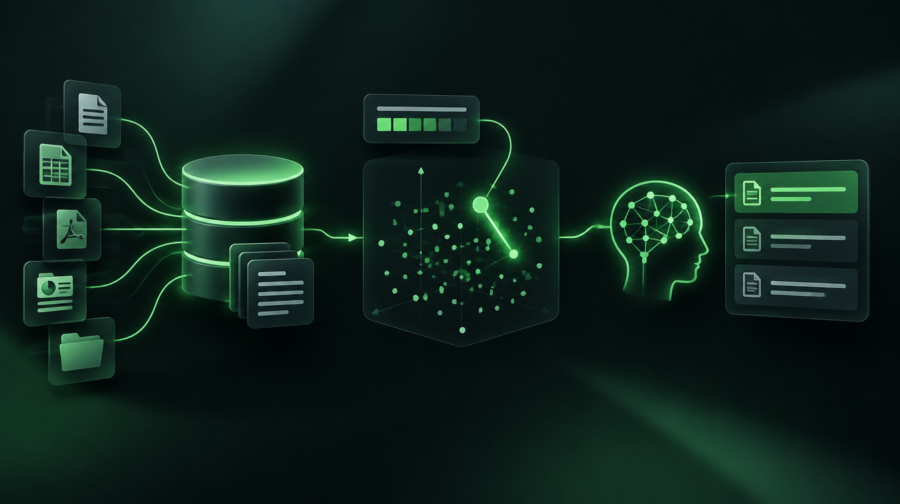
Das technische Herzstück von RAG sind Embeddings. Dabei werden Texte in numerische Vektoren umgewandelt, die ihre inhaltliche Bedeutung repräsentieren. Ähnliche Texte liegen im Vektorraum nah beieinander – unabhängig von der genauen Wortwahl. Eine Suchanfrage wie „Urlaubsregelung für Projektleiter“ findet so auch ein Dokument, das von „Ferienanspruch leitender Mitarbeiter“ spricht.
Diese Vektoren werden in einer sogenannten Vektordatenbank gespeichert (z. B. Qdrant, Weaviate oder pgvector). Bei einer Nutzeranfrage wird der Fragetext ebenfalls in einen Vektor umgewandelt und mit den gespeicherten Vektoren verglichen. Die ähnlichsten Dokumente werden herausgefiltert und als Kontext an das Sprachmodell übergeben.
Typische Anwendungsfälle im Unternehmen
Internes Wissensmanagement
Mitarbeiter können in natürlicher Sprache nach Inhalten aus dem Intranet, Handbüchern oder Protokollen suchen – ohne zu wissen, wo genau die Information gespeichert ist.
Kundensupport und FAQ-Automatisierung
Support-Teams erhalten kontextualisierte Antwortvorschläge auf Basis der tatsächlichen Produktdokumentation, nicht auf Basis allgemeiner Trainingsdaten.
Compliance und regulatorische Dokumente
Rechtliche oder prozessuale Anfragen lassen sich gegen die eigene Dokumentenbasis abgleichen – mit nachvollziehbaren Quellangaben.
Was Unternehmen bei der Einführung beachten sollten
RAG klingt technisch überschaubar, bringt aber eigene Herausforderungen mit. Die Qualität der Antworten hängt stark von der Qualität der Wissensbasis ab: schlecht strukturierte, veraltete oder widersprüchliche Dokumente führen zu schlechten Ergebnissen. Auch die sogenannte Chunk-Strategie – also wie Dokumente in Abschnitte aufgeteilt werden – hat erheblichen Einfluss auf die Trefferqualität. Wer zu grob chunked, verliert Kontext; wer zu fein chunked, riskiert fragmentierte Antworten.
Darüber hinaus müssen Datenschutz und Zugriffsrechte von Anfang an mitgedacht werden. Eine RAG-Architektur, die sensible HR-Daten ohne Rollenprüfung ausliefert, schafft neue Risiken statt Mehrwert.
RAG ist eine der wirkungsvollsten Methoden, um KI mit relevantem Unternehmenswissen zu verbinden – ohne großen Trainingsaufwand. Wer die Qualität seiner Dokumente im Griff hat und Datenschutzaspekte frühzeitig einplant, kann damit schnell produktive Ergebnisse erzielen.